Архив метки: VulnerabilityRemediation

Продолжая комментарии к статье Ведомостей про роль ИИ в поиске новых уязвимостей, следует отметить следующее: не так страшно детектирование zero-day уязвимостей с помощью ИИ, сколько вепонизация n-day (или уже скорее n-hour 😉) уязвимостей с помощью ИИ

Продолжая комментарии к статье Ведомостей про роль ИИ в поиске новых уязвимостей, следует отметить следующее: не так страшно детектирование zero-day уязвимостей с помощью ИИ, сколько вепонизация n-day (или уже скорее n-hour 😉) уязвимостей с помощью ИИ

Продолжая комментарии к статье Ведомостей про роль ИИ в поиске новых уязвимостей, следует отметить следующее: не так страшно детектирование zero-day уязвимостей с помощью ИИ, сколько вепонизация n-day (или уже скорее n-hour 😉) уязвимостей с помощью ИИ. Т.е. использование ИИ для разработки эксплоитов на основе патчей и публичной информации об уязвимостях. Новую неизвестную уязвимость нужно ещё понять, где искать. А найдя, придумать вменяемый сценарий атаки с эксплуатацией этой уязвимости. Это работа на удачу, своего рода золотоискательство или, вспоминая Маяковского: "…та же добыча радия. В грамм добыча, в годы труды. Изводишь единого слова [уязвимости] ради тысячи тонн словесной руды [проверенного кода и неподтвердившихся гипотез эксплуатации]." Конечно, в случае использования ПО с открытым кодом задача анализа упрощается. Но всё равно найти что-то стоящее весьма непросто. Поэтому, кстати, я противник того, чтобы результаты этой добычи бесконтрольно утекали за рубеж.

Другое дело, когда уязвимость уже известная, с присвоенным CVE, вендорским описанием, признанной критичностью и выпущенным патчем. Тут задача серьёзно упрощается.

🔹 Понятно, где искать. Очевидно, там, где вендор исправляет что-то патчем.

🔹 Понятно, что нужно получить в результате. То, о чём вендор сообщил в описании уязвимости.

Задача разобраться, как именно эксплуатировать уязвимость и разработать утилиту для этого тоже непростая, но всё же гораздо проще, чем искать что-то совершенно новое. Этим можно заниматься на потоке. Например, маркетинг компании watchTowr Labs практически полностью построен на том, что они быстро анализируют патчи для устранения уязвимостей сетевых устройств и публикуют по ним публичные исследования и эксплоиты.

Естественно, этим занимаются не только исследователи watchTowr Labs. 😏 Тем более, что ИИ-агенты значительно упрощают процесс вепонизации, а то и полностью его автоматизируют. Как сообщает Денис Макрушин, стоимость автономной разработки эксплоита сейчас может составлять даже меньше 3 долларов. И ведь прогресс в ИИ пока не останавливается! Разработанные эксплойты могут выкладываться исследователями в паблик ради самопиара и общественного блага (ну, как они его себе видят), а могут и не выкладываться, а, например, продаваться на чёрном рынке. 😈 А затем эти эксплоиты будут использоваться в атаках на организации, пока их не спалят и факт эксплуатации уязвимости не станет подтверждённым. И всё это бесконечно повторяется для всё новых и новых уязвимостей. It's the circle of life and it moves us all…

Что вся эта движуха означает для простого VM'щика? Нарратив, который двигали многие VM-вендоры: "Патчьте только 3% уязвимостей, которые мы вам подсветим, а на остальные просто забейте", с самого начала выглядел булшитненько и безответственно, а в условиях ускорения и удешевления вепонизации n-day-уязвимостей и подавно. Аргументов, что любая уязвимость может внезапно выстрелить и привести к инциденту, значительно прибавилось. А значит, нужно стремиться к приоритизированному устранению всех уязвимостей, что создаёт значительную нагрузку на IT, особенно если IT-инфраструктура организации не была изначально рассчитана на непрерывную установку и тестирование обновлений безопасности. 🤷‍♂️ То, что VM-щик сможет запросто влиять на изменение инфраструктуры организации - сценарий более чем оптимистичный, на который не стоит всерьёз рассчитывать. Но агитировать за такие архитектурные изменения и стараться заводить задачи на устранение всех выявленных уязвимостей - святая обязанность VM-щика. Делай, что должен, и будь, что будет.
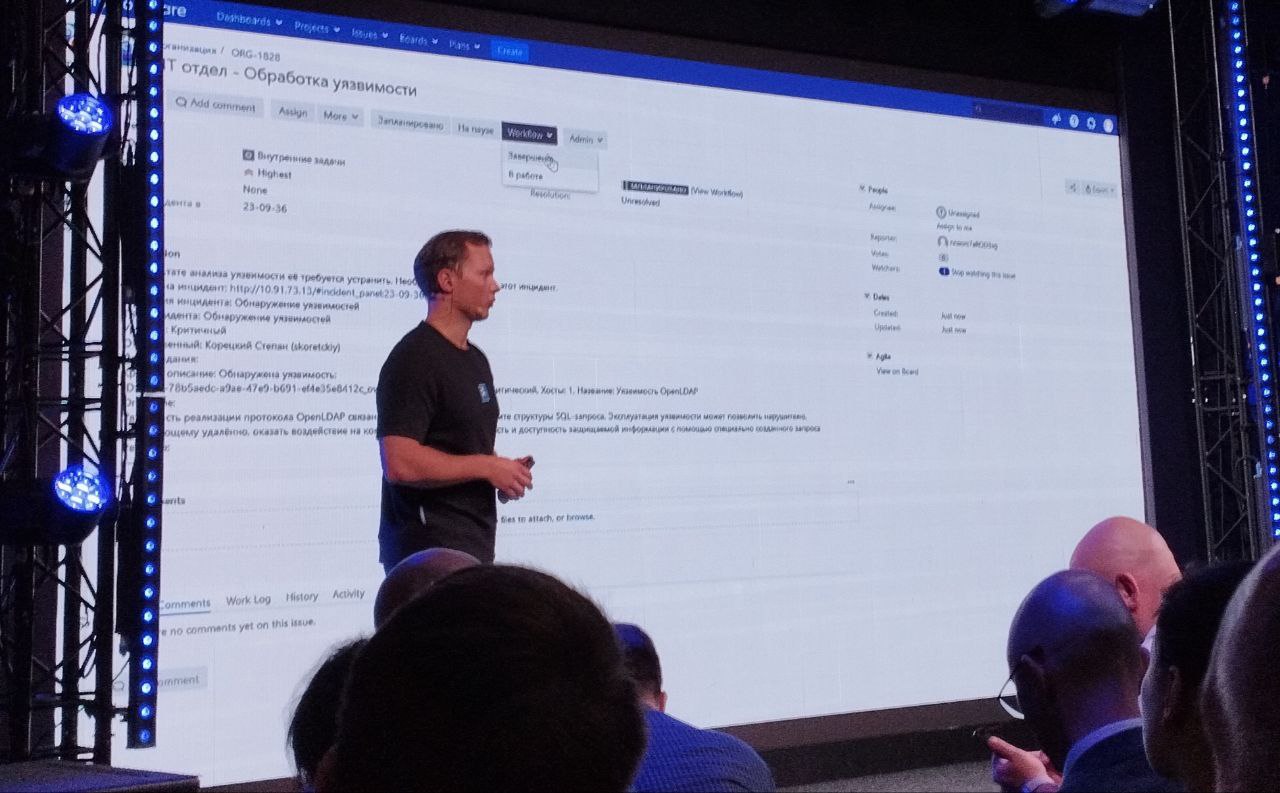
Ещё одно размышление после конференции R-Vision, про таски на исправление уязвимостей

Ещё одно размышление после конференции R-Vision, про таски на исправление уязвимостей

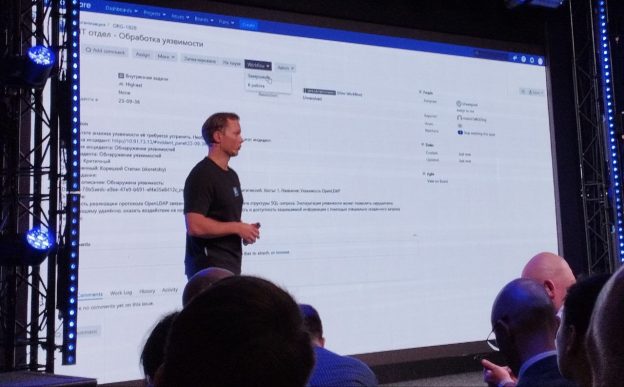
Ещё одно размышление после конференции R-Vision, про таски на исправление уязвимостей. На этой теме был акцент и в основном выступлении про R-Vision VM, и в кейсе НРД. Несмотря на то, что таски могут быть предметом долгих разбирательств IT и ИБ, имхо, таски должны быть. Почему?

1. Слова (как и дашборды, доступ для IT-шников в VM-систему, нотификации в почте/мессенджерах и прочее) к делу не пришьёшь. А тут формальная задачка. С критичностью, исполнителем и датой заведения. И для аудитов есть, что показать, и в случае инцидента пригодится. 😏
2. Вполне вероятно, что в организации уже внедрены процессы оценки эффективности работы подразделений на основе анализа статусов тасков, можно и исправление уязвимостей оценивать по аналогии.
3. Руководство ФСТЭК требует заводить таски. Можно, конечно, рассуждать об обязательности этого руководства, но если можно соответствовать, то лучше соответствовать. 😉

Какие это должны быть таски?

Имхо, это должны быть атомарные таски 1 актив и 1 уязвимость. Почему так?

1. Удобно отслеживать реальный прогресс. Иначе, если сделать связь один ко многим или многие ко многим, как абсолютно справедливо заметил в своём вчерашнем докладе Олег Кусеров, это будет приводить к большому количеству частично выполненных тасков.
2. Удобно менять критичность таска в случае изменения критичности уязвимости или актива.
3. Удобно делать интеграцию с системами управления уязвимостями. По сути таск просто привязывается к статусу уязвимости на активе.

Сколько таких тасков будет? Допустим, у нас для одного Linux хоста за месяц выходят 100 новых уязвимостей. Допустим, у нас 10000 Linux хостов в инфраструктуре. Получается миллион тасков за месяц. 12 миллионов в год. И это только Linux!

Отсюда следует:
1. Система для учёта тасков должна быть готова к таким объемам.
2. Вручную работать с такими тасками практически нереально.

Таски должны заводиться и закрываться автоматически по результатам детектирования уязвимостей.

✅ Таким образом ITшники, которые будут выполнять регулярный патчинг своих систем, возможно вообще без оглядки на продетектированные уязвимости, будут, в целом, автоматически соответствовать требованиям по исправлению уязвимостей и будут молодцы. 👍

❓А те ITшники, которые считают, что полное регулярное обновление им не подходит, смогут разбираться с каждой уязвимостью отдельно и тем способом, который сочтут нужным. Включая их ручную обработку. 🤷‍♂️ Может в процессе они скорректирую свои взгляды относительно регулярных обновлений. 😏

Способ затормозить Vulnerability Management процесс "ты как челобитную царю подаёшь?!"

Способ затормозить Vulnerability Management процесс ты как челобитную царю подаёшь?!

Способ затормозить Vulnerability Management процесс "ты как челобитную царю подаёшь?!" 👑 Несколько разовью тему с офигиванием IT-шников от VM-а и того, что они могут придумать в ответ. Данный способ простой, эффективный и без формальных изъянов. Подходит как самая первая мера. ITшники говорят, что, разумеется, они готовы обновлять системы, но для того, чтобы заниматься этим на потоке, им необходимо, чтобы информация об обнаруженных уязвимостях доводилась до них несколько иначе, чем сейчас:

🔻 В виде тасков в таск-треккере (1 уязвимость - 1 хост, сгруппированные по уязвимостям, сгруппированные по хостам)
🔻 В виде REST API вызовов (всё сразу, по хосту, по уязвимости)
🔻 В виде выгрузок на гитлабе, файловой шаре, в монге, кафке (CSV, XML, JSON, YAML)

Требуемое описание уязвимости может содержать в себе любой набор полей, включая, например перевод описания уязвимости. Мы же российская компания - давайте нам всё на русском. 😏 И прямые ссылки на патчи, пожалуйста! И команду для полного обновления хоста! И команду для частичного обновления хоста (только самое критичное)! И прямые ссылки на PoCи (непонятно зачем, но тоже пусть будет - нам интересно 🙂)!

Конкретные требования значения не имеют, т.к. весь расчет на то, что пока вы будете возиться с тасками/выгрузками в том виде, в котором это захочется IT (а каждому отделу может хотеться разного), вы не будете их доставать с патчингом. А после можно будет придумать что-нибудь ещё. 💡

Кроме того, в случае тасков в таск-треккере, они наглядно смогут показать, что в итоге получилась какая-то абсолютно неюзабельная ерунда. Работать вручную с тысячами автогенеренных тасок по уязвимостям будет, естественно, невозможно. Сразу что ли было непонятно, товарищи VM-щики?! 🙃 Но это будет потом, после месяцев потраченных на встречи, обсуждения, согласования и разработку. 😏

Что с этим делать? Конечно, нужно стараться предоставлять коллегам из IT данные по уязвимостям в удобном для них виде. Но также нужно чётко отслеживать, когда они начинают юлить и водить вас за нос. В этом случае следует говорить твёрдое "нет, работайте с тем, что есть" и эскалироваться в случае их отказа работать по процессу.

Постоянное офигивание ITшников это нормальное следствие работающего Vulnerability Management процесса

Постоянное офигивание ITшников это нормальное следствие работающего Vulnerability Management процесса

Постоянное офигивание ITшников это нормальное следствие работающего Vulnerability Management процесса. В чём вообще задача процесса Управления Уязвимостями? В том чтобы в инфраструктуре не было критичных уязвимостей и ими не мог воспользоваться злоумышленник. Именно за это VM-щику платят деньги и за это он отвечает (при плохом раскладе вплоть до уголовки 🤷‍♂️). А для того, чтобы таких уязвимостей в инфраструктуре не было, их нужно (сюрприз-сюрприз!) исправлять. 🙂 Чаще обновлениями, реже переконфигурированием.

Если уж в организации есть какой-никакой процесс управления активами, то покрыть эти активы детектами и открыть бесконечный поток новых обнаруженных уязвимостей дело выполнимое. Насколько мощным будет этот поток? Если брать совсем минимум, то с Patch Tuesday обязательно прилетит KB-шная RCE-шка в Windows ядре или стандартном компоненте, а также RCE в Linux-овом ядре или стандартной утилите. По сетевым устройствам возможно пореже - раз в 2 месяца. Вот и считай - ежемесячное обновление всех Linux/Windows хостов и двухмесячное для всех сетевых устройств. И это с необходимостью эти обновления тестировать перед накаткой. 👨‍🏫 Это минимум!

Класс, да? Каждый админ/девопс будет просто счастлив открывающимся перспективам дополнительно свалившейся на него со стороны ИБшников работы! 🙂 Как и его руководители вплоть до CIO/CTO. И будьте уверены, что они приложат все возможные усилия и все доступные меры корпоративной борьбы, чтобы этого замечательного VM-процесса в итоге не случилось. Не говоря уж о таких мелочах как разнообразные "словесные интервенции". 📣😏

Крепись, VM-щик! Не позволяй выхолостить процесс!